Chetumal, Quintana Roo.— Un sitio de internet puede funcionar aparentemente con normalidad, publicar noticias, recibir visitantes y mostrar su portada habitual, mientras en paralelo los buscadores reciben una página completamente distinta. Es una modalidad de ataque particularmente difícil de detectar que utiliza técnicas conocidas como cloaking y, en un sentido más amplio, mecanismos de persistencia o contenido “fantasma” que pueden permanecer ocultos durante semanas.
El caso recientemente detectado en El Punto Sobre la i permite observar cómo funcionan este tipo de ataques. Durante la revisión del portal se comprobó que Google llegó a recibir contenido fraudulento relacionado con sitios de acompañantes en Turquía, pese a que los lectores que ingresaban normalmente al medio veían las noticias de Quintana Roo.
La explicación estaba escondida dentro de los archivos del servidor.
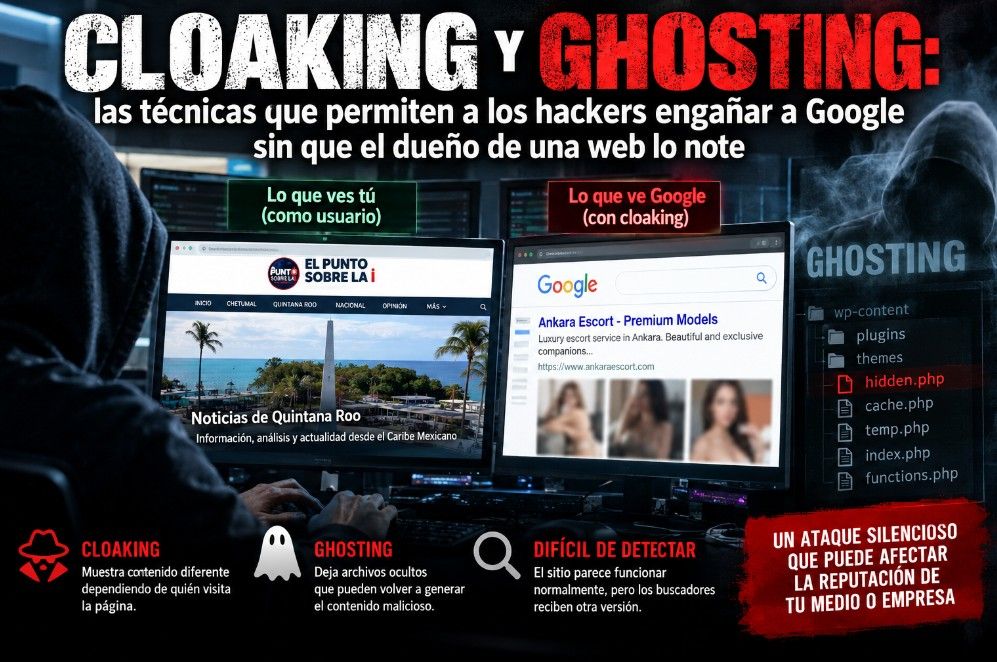
El cloaking: una página para el lector y otra para Google
El término cloaking —que puede traducirse como encubrimiento— describe una técnica mediante la cual un servidor entrega contenido diferente dependiendo de quién solicita la página.
En ataques de SEO spam, los delincuentes pueden programar el código para identificar a Googlebot u otros rastreadores. Cuando entra un usuario común, el sitio funciona normalmente; cuando llega Google, aparece una página preparada específicamente para ser indexada.
Esto dificulta considerablemente la detección.
El administrador entra a su portal y todo parece normal. Los periodistas publican, las fotografías cargan y los lectores continúan navegando. Sin embargo, Google puede estar recibiendo títulos, enlaces, palabras clave y páginas fraudulentas.
En el caso investigado en El Punto Sobre la i, el código malicioso era todavía más sofisticado: no se limitaba a buscar la palabra “Googlebot” en el navegador, sino que incluía mecanismos para comprobar si la petición realmente procedía de infraestructura utilizada por Google.
Una vez identificado el rastreador, el código descargaba contenido desde servidores externos y lo mostraba en sustitución de la portada legítima.
Así fue posible que Google llegara a presentar resultados relacionados con contenido en turco mientras los lectores continuaban viendo un portal de noticias de Quintana Roo.
El “ghosting”: la infección que parece haber desaparecido
En seguridad informática, ghosting no tiene una definición única y estandarizada equivalente a cloaking. El término se utiliza informalmente en distintos contextos para referirse a elementos que permanecen ocultos, reaparecen o dejan rastros difíciles de localizar.
En una infección web, el fenómeno puede observarse cuando se elimina el archivo visible que contiene el spam, pero permanece el código que lo vuelve a crear.
Eso ocurrió durante el incidente analizado.
Uno de los archivos que aparecía en el servidor contenía una página completa de spam. Borrarlo parecía inicialmente suficiente.
No lo era.
La investigación permitió descubrir posteriormente un archivo PHP oculto dentro de la estructura de WordPress que tenía capacidad para volver a generar el contenido fraudulento. Mientras ese código permaneciera activo, eliminar solamente la página de spam atacaba el síntoma, pero no la infección.
Una intrusión que comenzó semanas antes
La investigación posterior del proveedor de alojamiento Webempresa aportó un dato todavía más relevante: la actividad maliciosa no comenzó cuando Google mostró el contenido fraudulento.
De acuerdo con la revisión comunicada por el proveedor, la primera actividad maliciosa registrada ocurrió el 12 de julio de 2026, cuando fue subido un archivo PHP mediante el Gestor de Ficheros de WePanel desde una dirección IP externa.
Posteriormente, el 6 de agosto, se detectó otra acción desde una segunda dirección IP que vinculó código malicioso al funcionamiento normal de WordPress.
Al día siguiente ya existían rastros de archivos de caché utilizados por el malware.
La cronología demuestra uno de los principales peligros de este tipo de ataques: la fecha en que el propietario descubre el problema no necesariamente corresponde con la fecha en que comenzó la intrusión.
¿Por qué los delincuentes quieren aparecer en Google?
El objetivo de muchas de estas operaciones no es destruir una página.
Por el contrario, necesitan que siga funcionando.
Un dominio con años de existencia, contenido original, miles de páginas indexadas y cierta reputación ante los buscadores puede resultar atractivo para grupos dedicados al llamado SEO spam.
El atacante aprovecha esa reputación para intentar posicionar contenido que difícilmente conseguiría visibilidad utilizando un dominio nuevo.
Por ello puede convenirle mantener intacta la página que ven los usuarios mientras presenta otra versión exclusivamente a los motores de búsqueda.
El propietario puede tardar en enterarse hasta que busca el nombre de su empresa o medio en Google y descubre títulos completamente ajenos a su actividad.
Google puede conservar el “fantasma” después de limpiar la web
Existe además otro fenómeno que puede generar confusión.
Aunque el servidor haya sido desinfectado, Google puede conservar temporalmente en su índice el título y la descripción que encontró durante rastreos anteriores.
Esto significa que ver spam en un resultado de búsqueda no demuestra por sí mismo que el servidor continúe infectado. Es necesario comprobar qué contenido está recibiendo Google en ese momento.
En el caso de El Punto Sobre la i, después de retirar el código identificado se utilizó la prueba de URL publicada de Google Search Console. El buscador volvió a recibir la portada legítima del medio.
Posteriormente se solicitó una nueva indexación.
El resultado ya es visible: Google volvió a mostrar como título principal “El Punto Sobre La i: Noticias de Quintana Roo”, acompañado de la descripción periodística correspondiente y enlaces internos hacia noticias y secciones del portal.
Borrar el spam no significa eliminar al atacante
El caso deja una advertencia para administradores de periódicos digitales, empresas, instituciones y cualquier organización que dependa de WordPress.
Cuando aparece una página extraña en Google, no basta con localizarla y borrarla.
Es necesario determinar quién la genera, cómo llegó el código al servidor y si existen puertas traseras capaces de reconstruir la infección.
También deben revisarse las credenciales del alojamiento, usuarios administrativos, plugins, plantillas, archivos del núcleo, tareas programadas y registros de acceso. El cambio de contraseñas y la autenticación de dos factores resultan especialmente importantes cuando existen indicios de que el panel del alojamiento pudo ser utilizado durante la intrusión.
En este caso, la investigación continúa para determinar con precisión el mecanismo utilizado en el acceso inicial y descartar cualquier persistencia adicional.
La experiencia demuestra por qué el cloaking representa una amenaza silenciosa: una página puede parecer completamente sana ante sus propietarios y lectores mientras, detrás de escena, alguien intenta utilizar su reputación y su nombre para mostrarle a Google una realidad completamente diferente.